NVIDIA
279
총 블로그 글 수

NVIDIA의 블로그 글

총 279개의 글
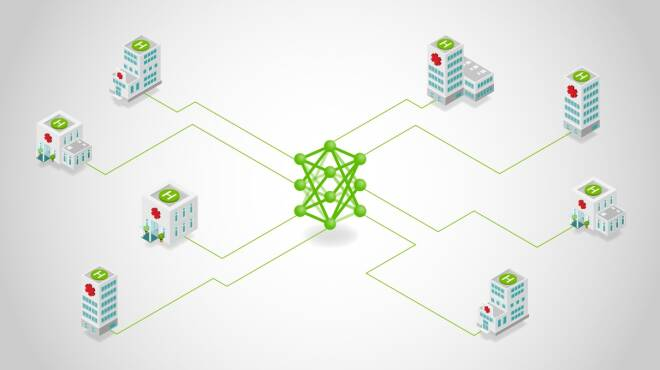
NVIDIA FLARE를 활용한 Docker, Kubernetes 및 Slurm 전반에 걸친 연합 학습 확장
2026-09-15 04:26
Scaling Federated Learning Across Docker, Kubernetes, and Slurm with NVIDIA FLARE
NVIDIA Groq 3 LPX의 결정론적 실행이 NVIDIA Vera Rubin에서 전력 효율이 높고 상호작용성이 뛰어난 추론을 어떻게 실현하는지
2026-09-15 04:26
How NVIDIA Groq 3 LPX Deterministic Execution Drives Power-Efficient High-Interactivity Inference on NVIDIA Vera Rubin
NVIDIA NVLink 6가 AI 팩토리에 다층적 복원력을 제공하는 방법
2026-09-15 04:26
How NVIDIA NVLink 6 Delivers Multi-Layer Resiliency for AI Factories
밀집 모델 대 MoE 모델: 활성 매개변수, 처리량, 그리고 각각을 선택해야 할 때
2026-09-15 04:26
Dense vs. MoE Models: Active Parameters, Throughput, and When to Choose Each
NVIDIA Transformer Engine을 활용한 JAX에서의 드롭리스 MoE 훈련 가속화
2026-09-14 04:27
Accelerating Dropless MoE Training in JAX with NVIDIA Transformer Engine
웨이퍼 출하부터 첫 토큰 발행까지: 네모트론(Nemotron)과 팔란티어 파운드리(Palantir Foundry)와 함께 공급망 전문 지식을 체계화하다
2026-09-10 04:25
From Wafer-Out to First Token: Codifying Supply Chain Expertise with Nemotron and Palantir Foundry
BioNeMo 추론 런타임을 활용한 고처리량 구조 예측
2026-09-10 04:25
High-Throughput Structure Prediction with BioNeMo Inference Runtime
풀스택 NIM 최적화를 통해 Nemotron 3 Ultra에서 사용자 수가 2.5배 증가한 비결
2026-09-10 04:25
How Full-Stack NIM Optimizations Deliver 2.5x More Users on Nemotron 3 Ultra
CUDA 툴킷 13.4, Windows on Arm 지원 및 공유 GPU에 대한 제어 기능 강화
2026-09-09 04:25
CUDA Toolkit 13.4 Adds Windows on Arm Support and Greater Control over Shared GPUs
다중 모달 모델 서빙을 가속화하기 위해 ‘인코딩-프리필-디코딩’ 분할 방식을 언제 사용해야 하는가
2026-09-09 04:25
When to Use Encode-Prefill-Decode Disaggregation to Accelerate Multimodal Model Serving

좋아요가 저장됐어요!

로그인하면 어디서나 확인하고
영구적으로 저장할 수 있어요.